无需CK!!需要配置代理
稳定收录
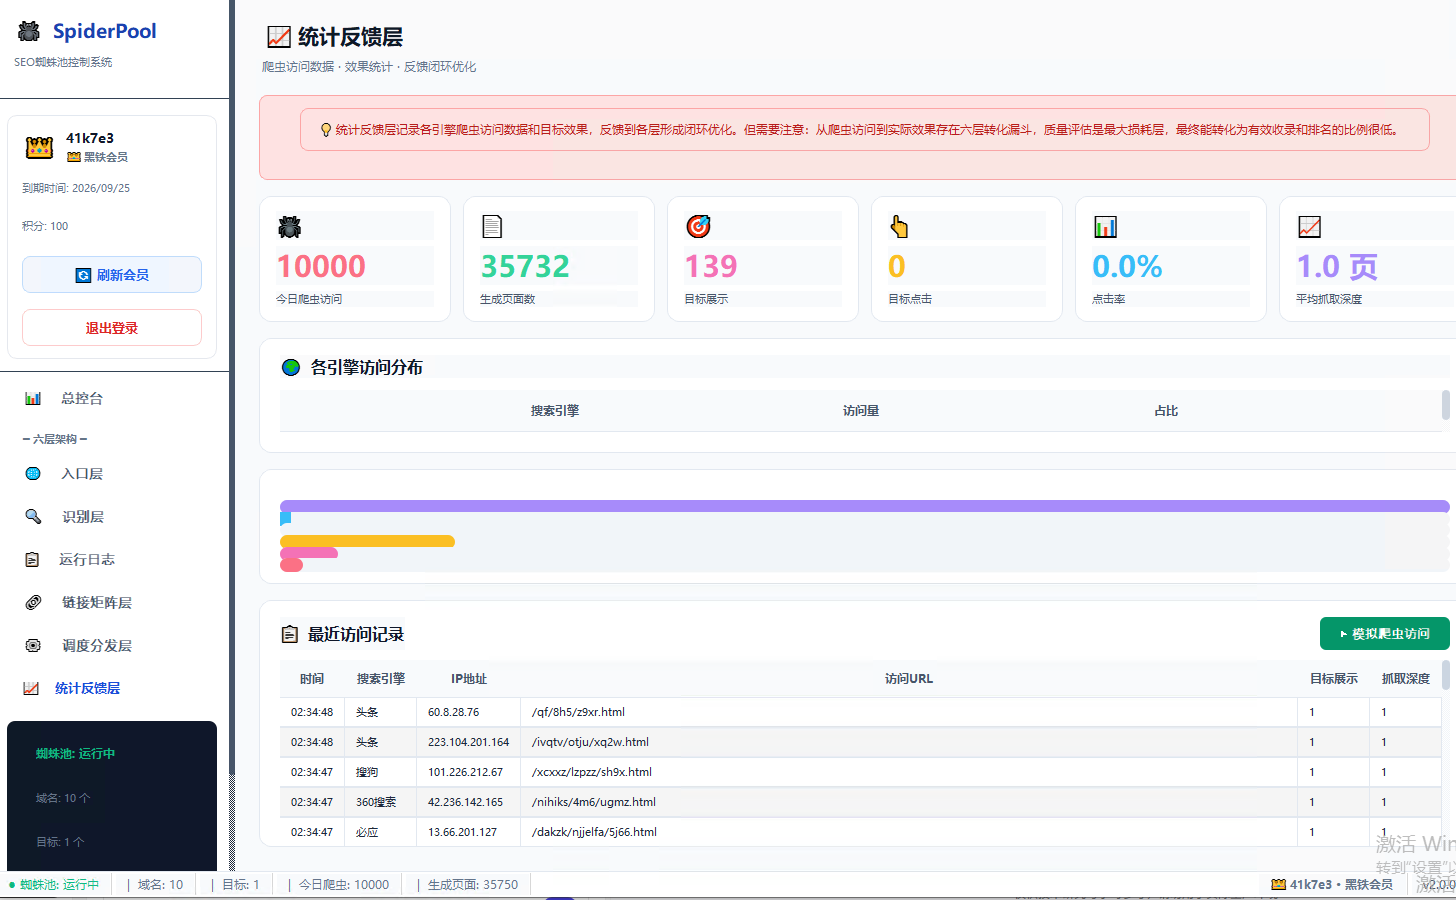
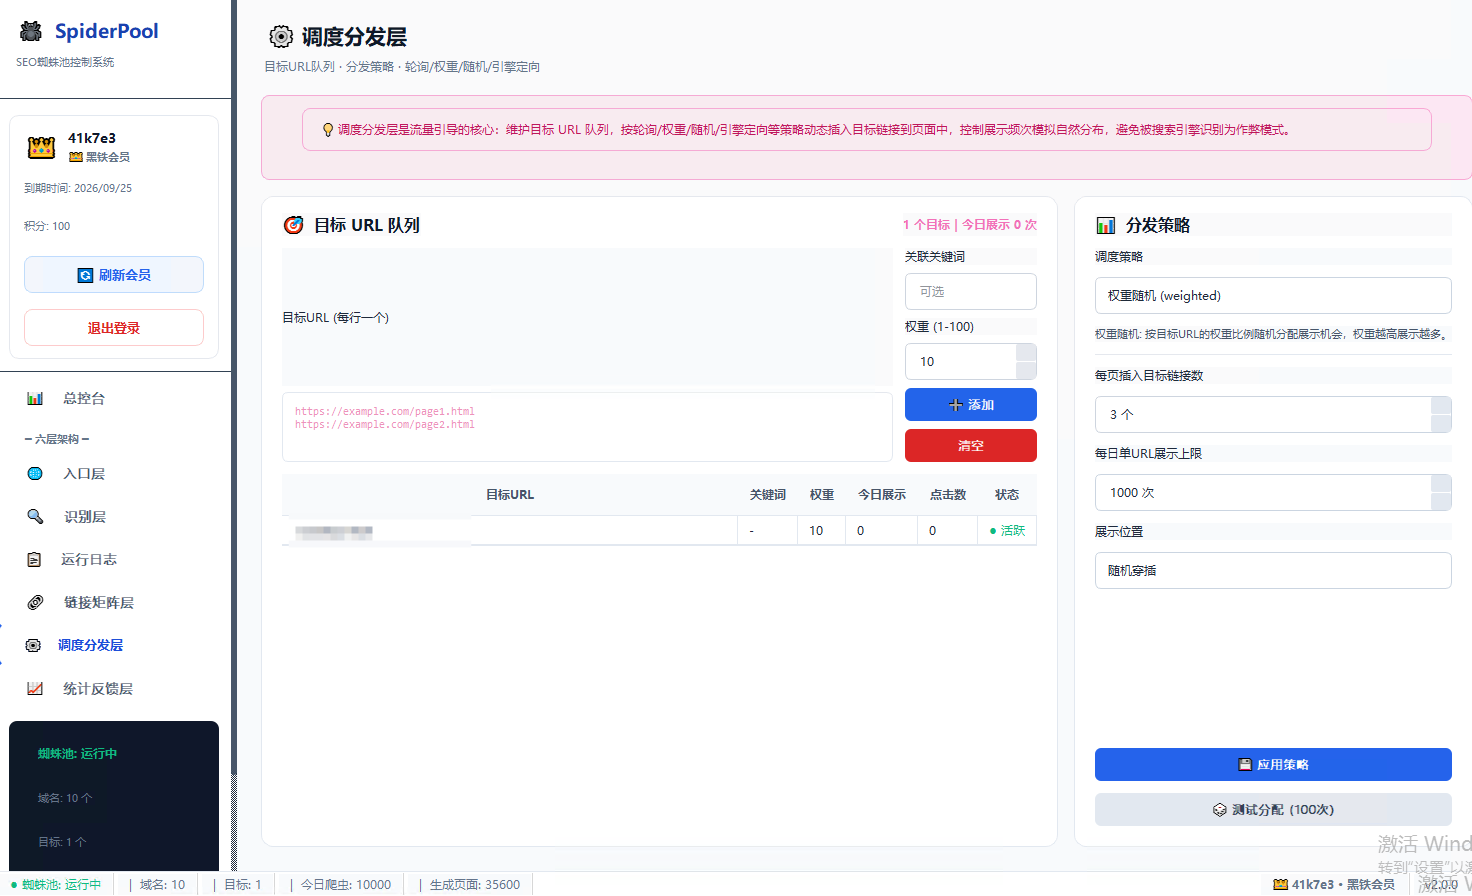
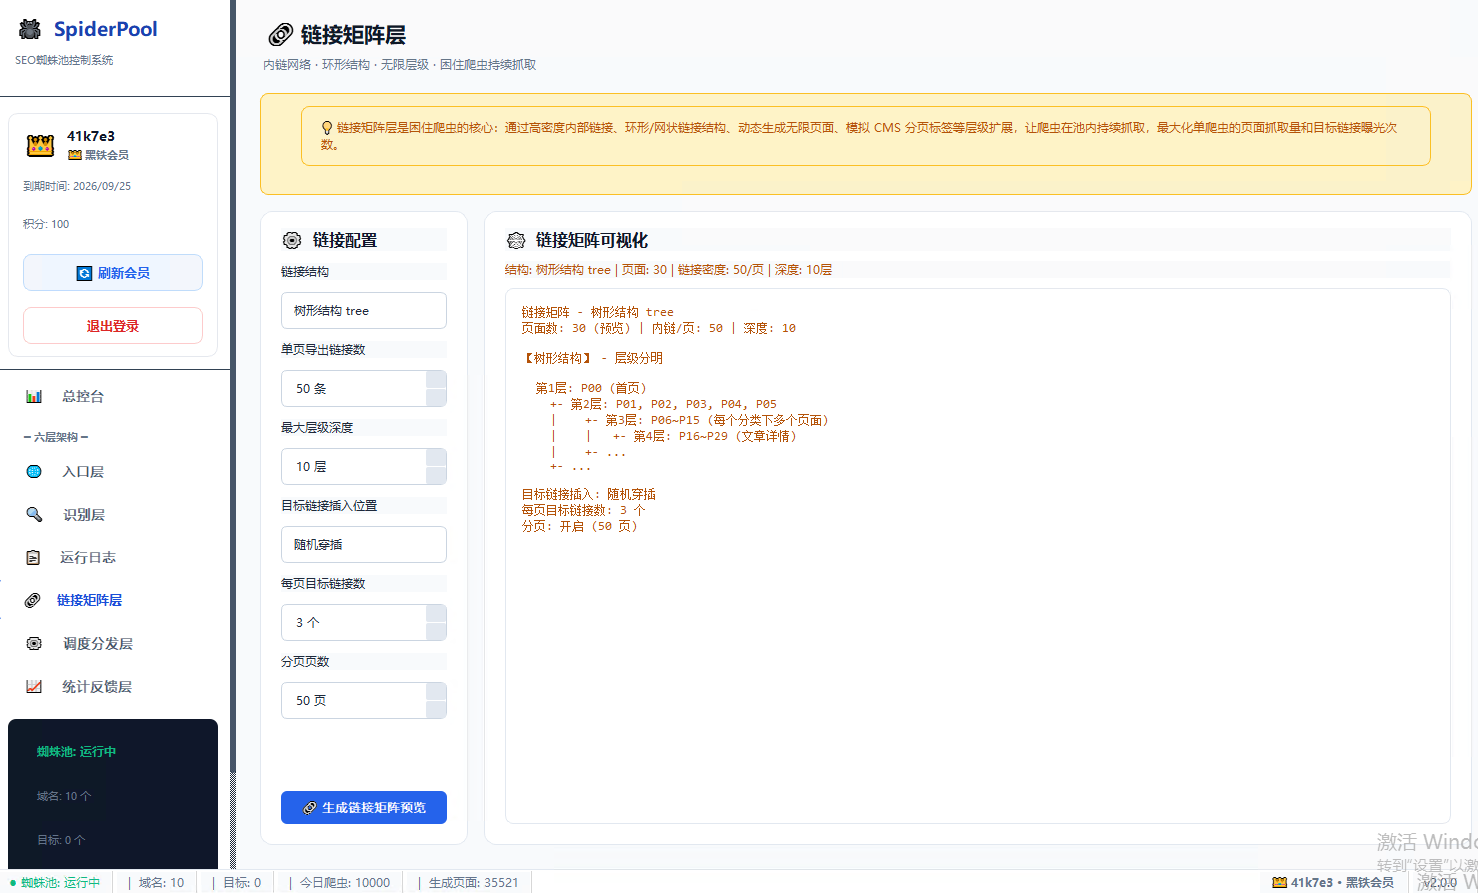
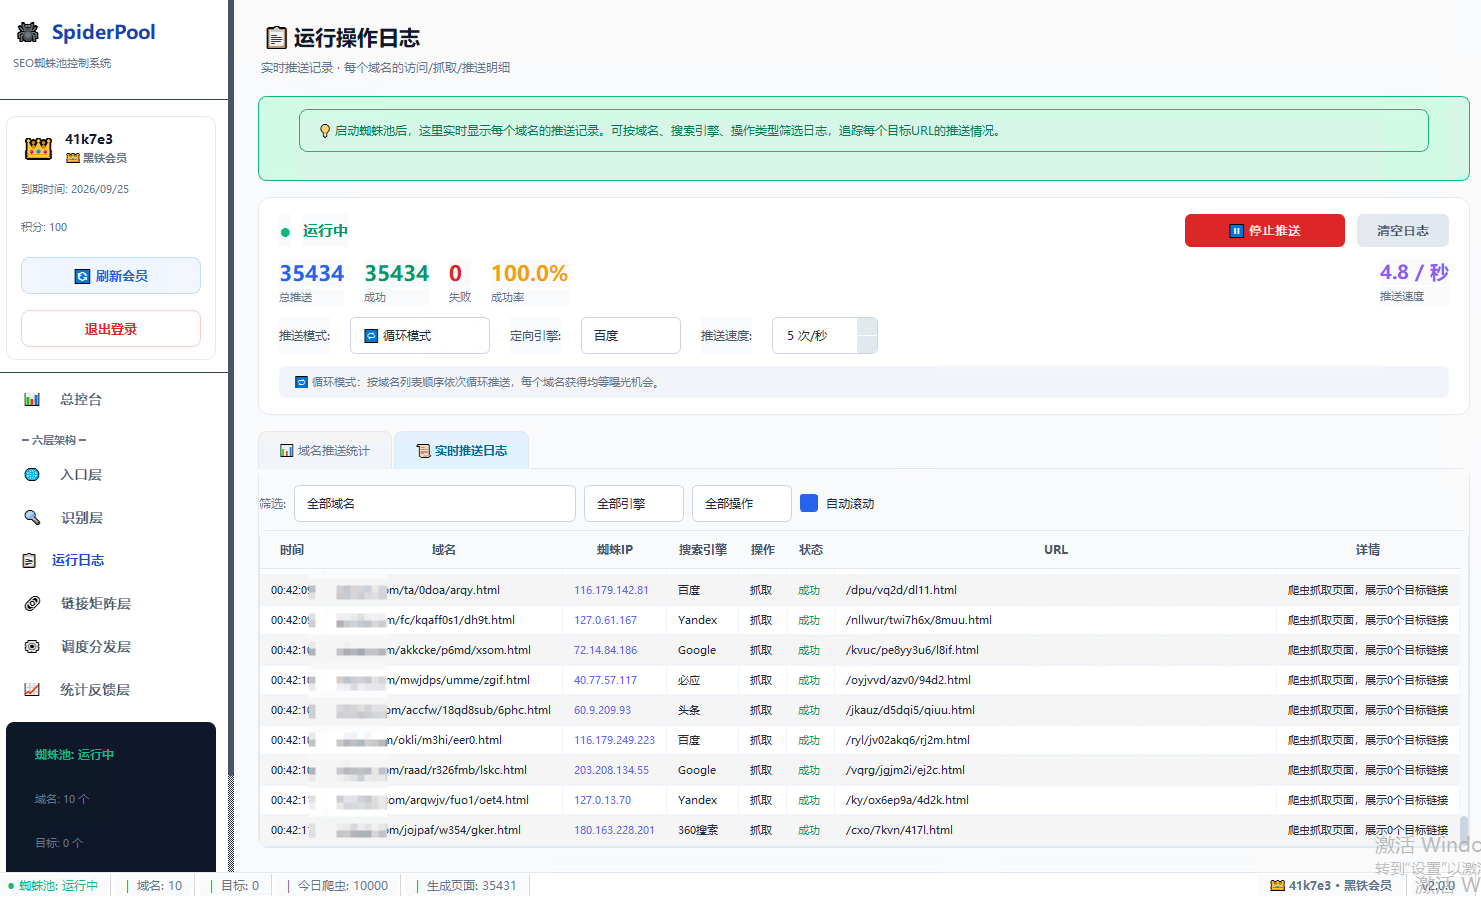
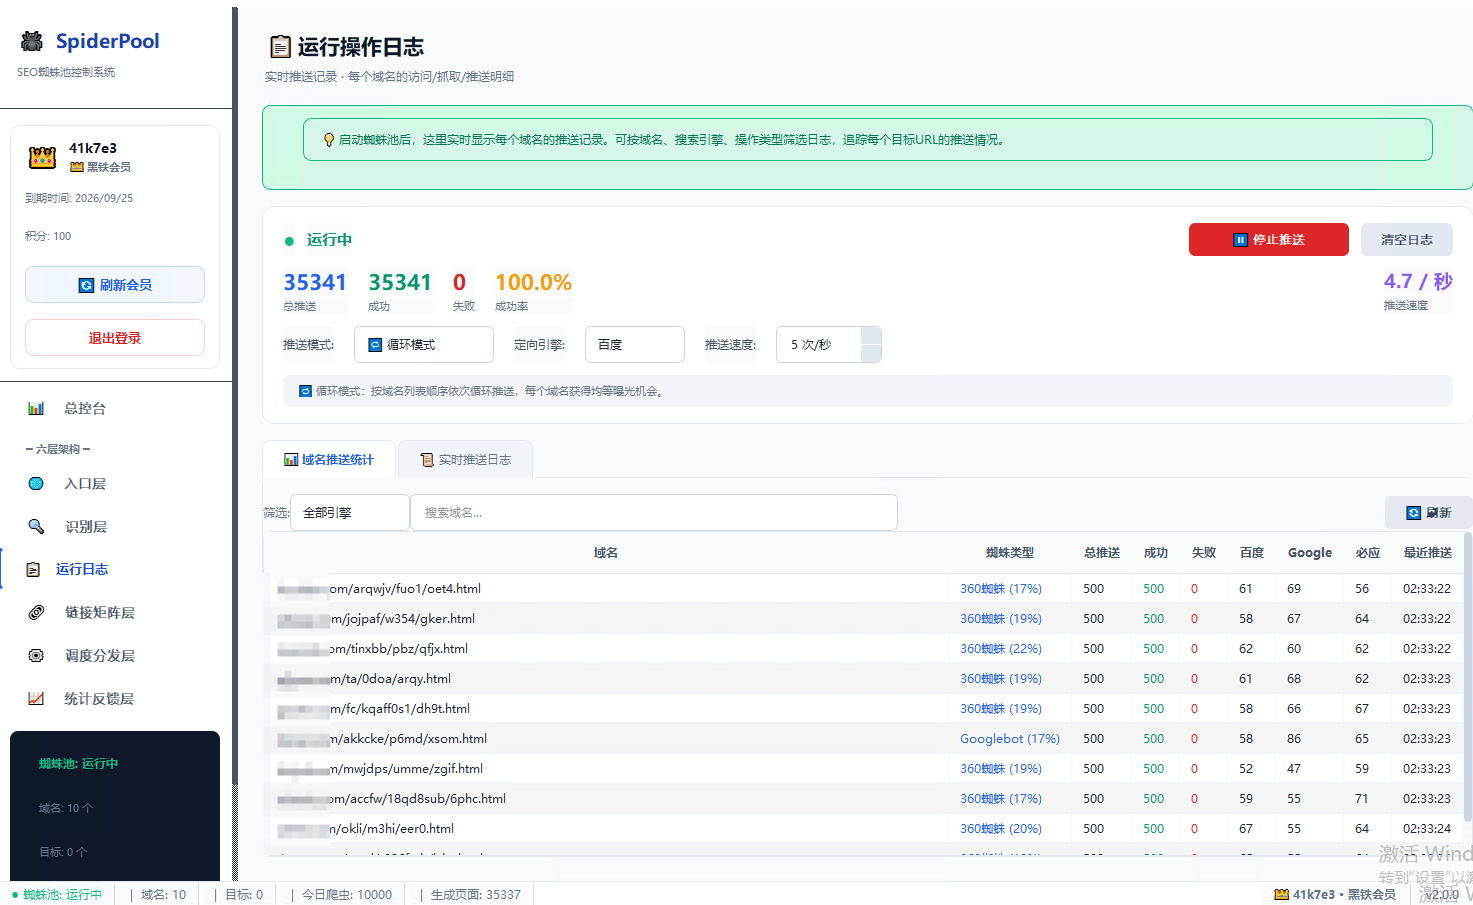
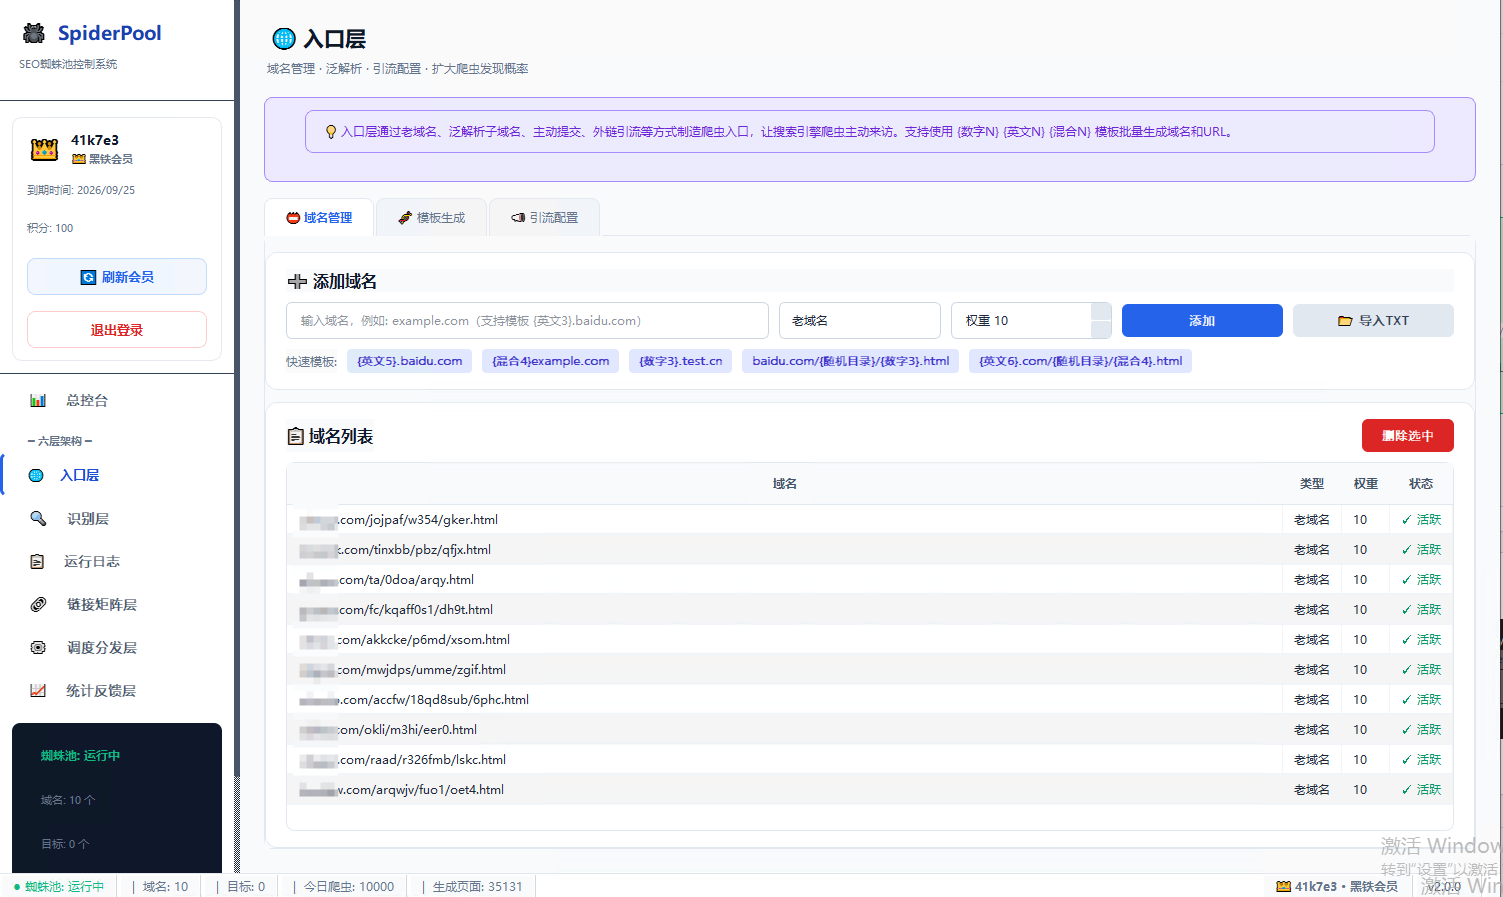
使用教程
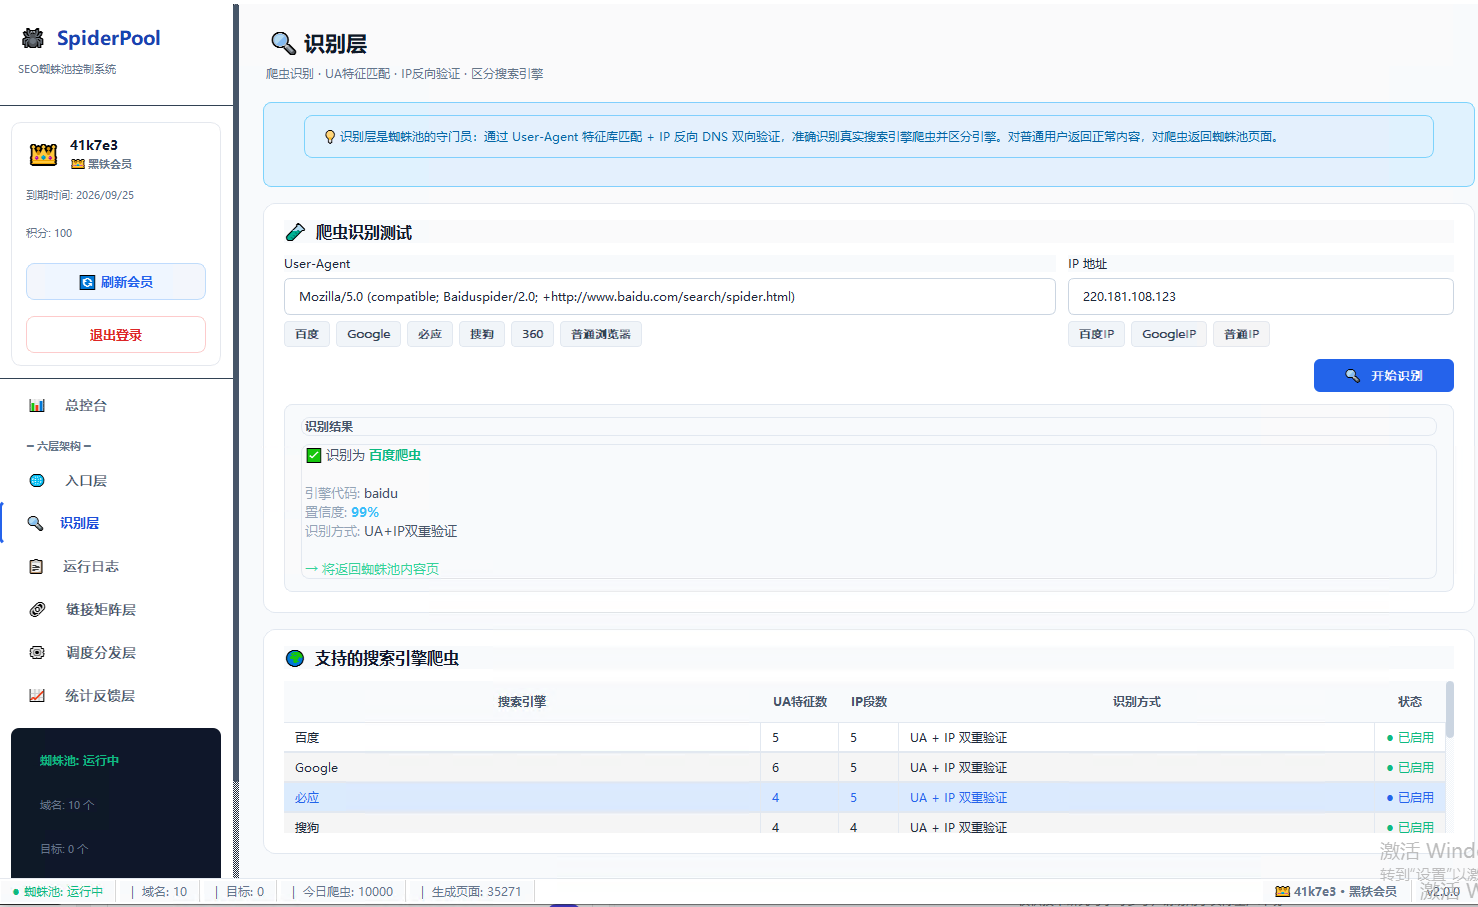
// 蜘蛛池识别层核心逻辑 function identifyCrawler(userAgent, ip) { // 第一步:UA 特征匹配 const uaMatch = matchUALibrary(userAgent); if (!uaMatch.isCrawler) { return { type: 'normal_user', action: 'show_normal_content' }; } // 第二步:IP 反向 DNS 验证 const reverseDns = reverseDNSLookup(ip); const ipValid = validateCrawlerIP(reverseDns, uaMatch.engine); if (!ipValid) { // 识别真假UA 是爬虫但 IP 不对 → 伪造 UA 的访问 return { type: 'fake_crawler', action: 'show_normal_content' }; } // 第三步:双向验证通过 → 返回蜘蛛池内容 return { type: 'real_crawler', engine: uaMatch.engine, action: 'show_spider_pool_content', targetUrls: getTargetUrlsForEngine(uaMatch.engine) }; }
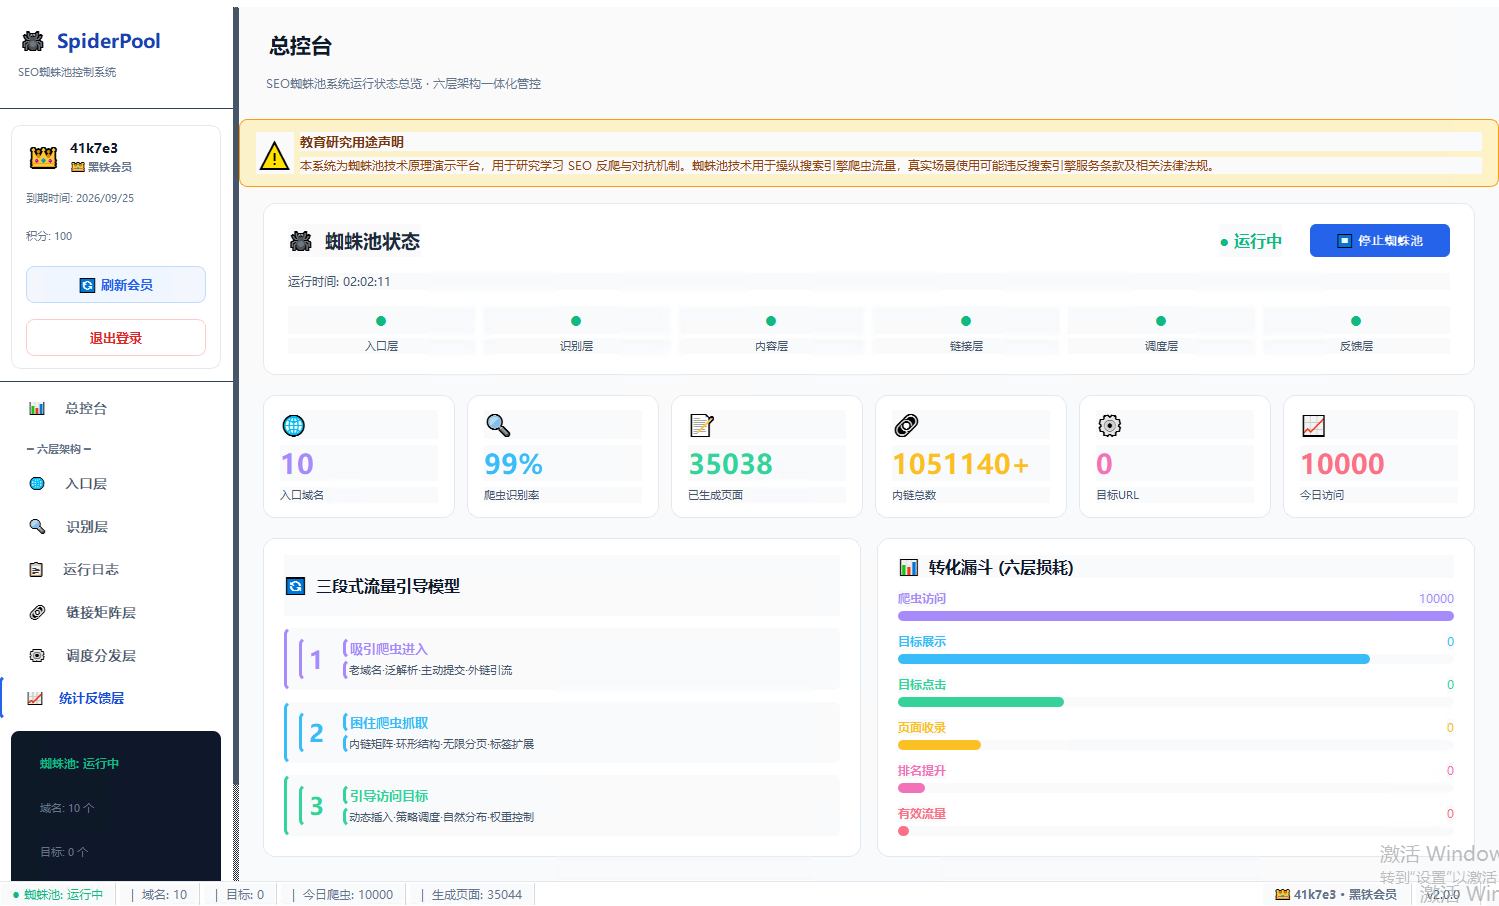
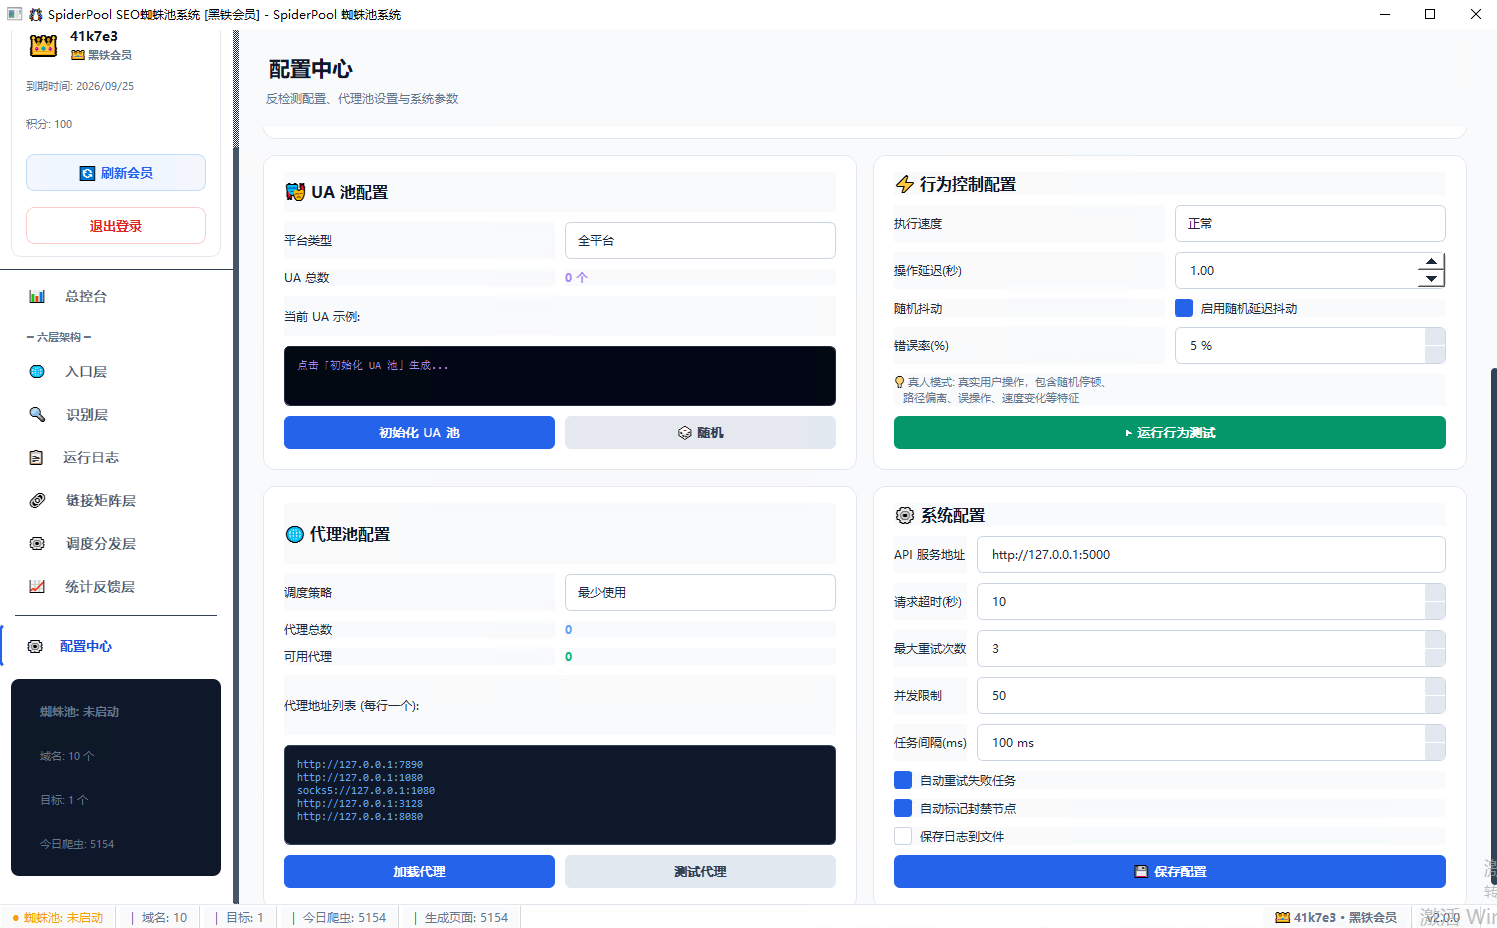

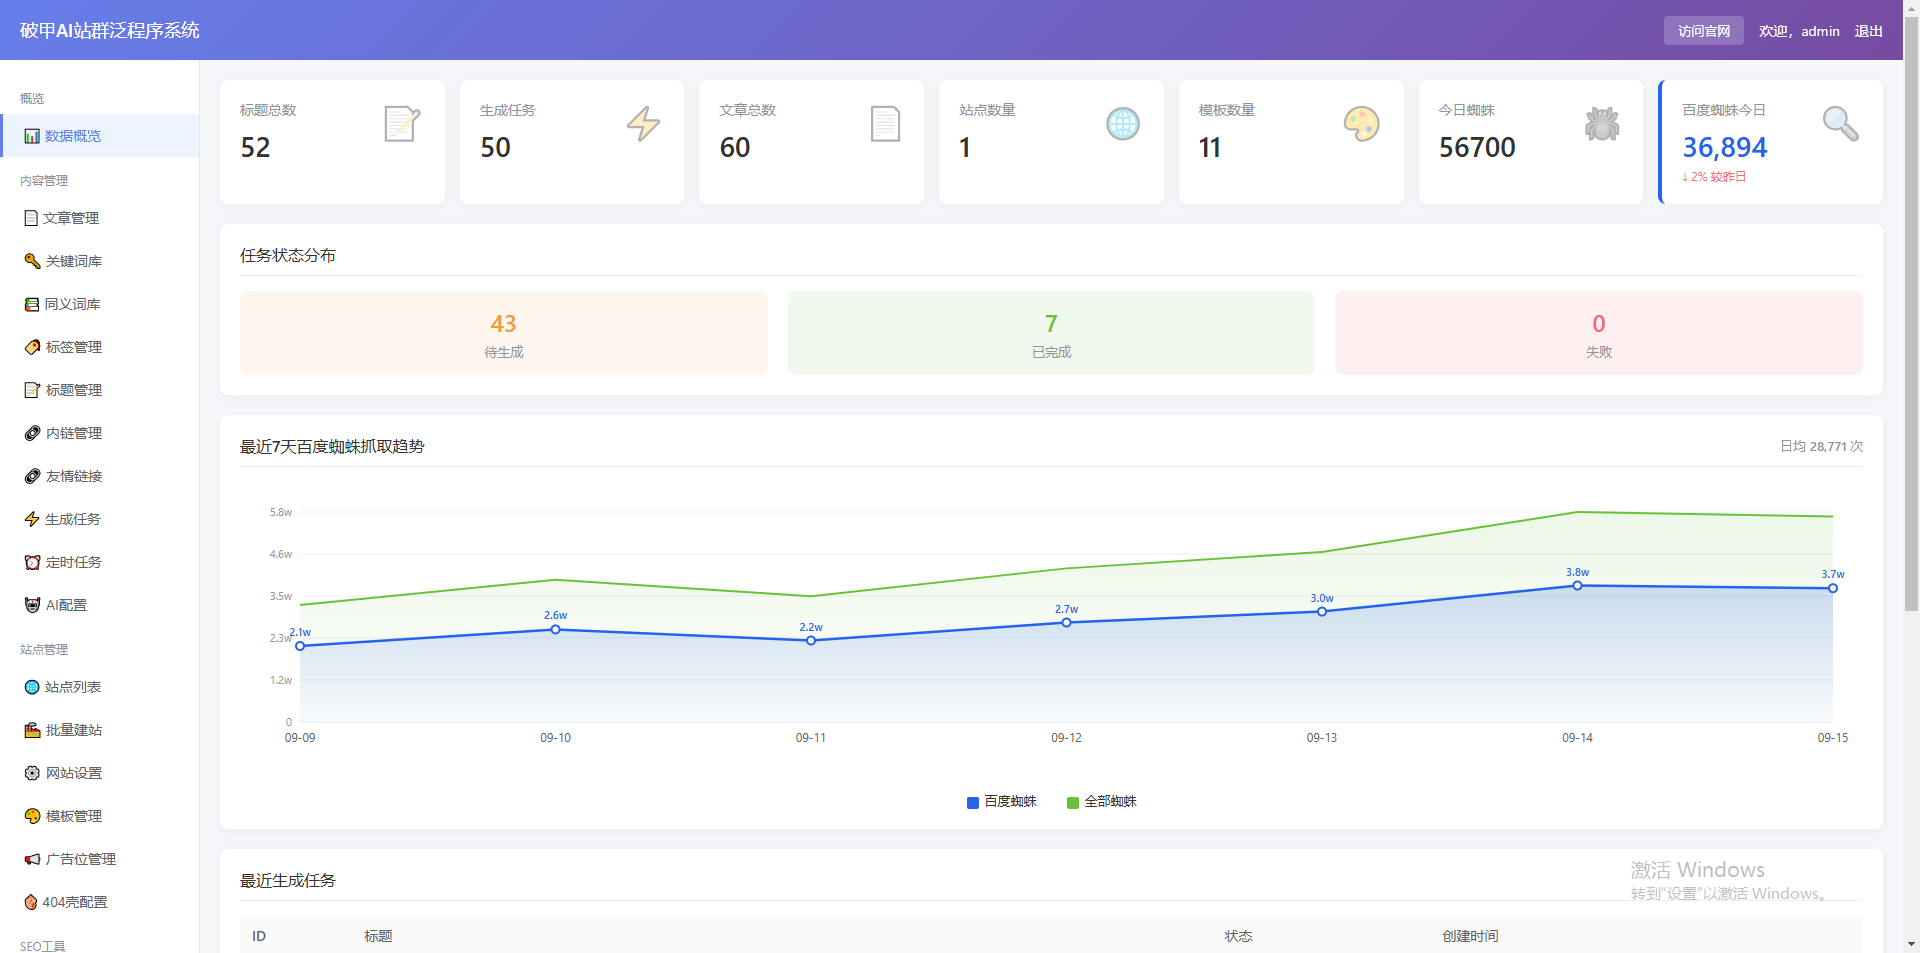
评论 0
还没有评论,来说两句。
请先 登录 后再发表评论。